说真的,2026年这波端侧AI是真的卷。DeepSeek-R1、Qwen3、Llama4轮番上场,身边不少朋友都把“本地跑模型”当成刚需了。问题是,笔记本毕竟不是服务器,8GB显存的RTX5060移动版到底能扛到哪一步?评论区一直有读者留言问,ThinkBook 16p 5GCD这套配置放在2026年10月这个时间点,还值不值得入手做本地大模型开发。
这篇文章就是把这个机器从开箱到跑通全流程完整拆一遍,所有版本号、踩坑记录都给你列清楚。事先声明:本人不是品牌方,文中所有结论都是自己一台机器实跑出来的,关键配置和价格会附上来源。
时效性说明:本文基于2026年10月市场情况撰写,适配NVIDIA Studio 590.x最新驱动、CUDA 12.8生态、Odysseus v0.5.3稳定版。Q4最新Studio驱动与PyTorch 2.7+对Blackwell架构有进一步优化,本文已在第三章补充适配说明。
一、硬件环境评估:8GB显存到底能干什么
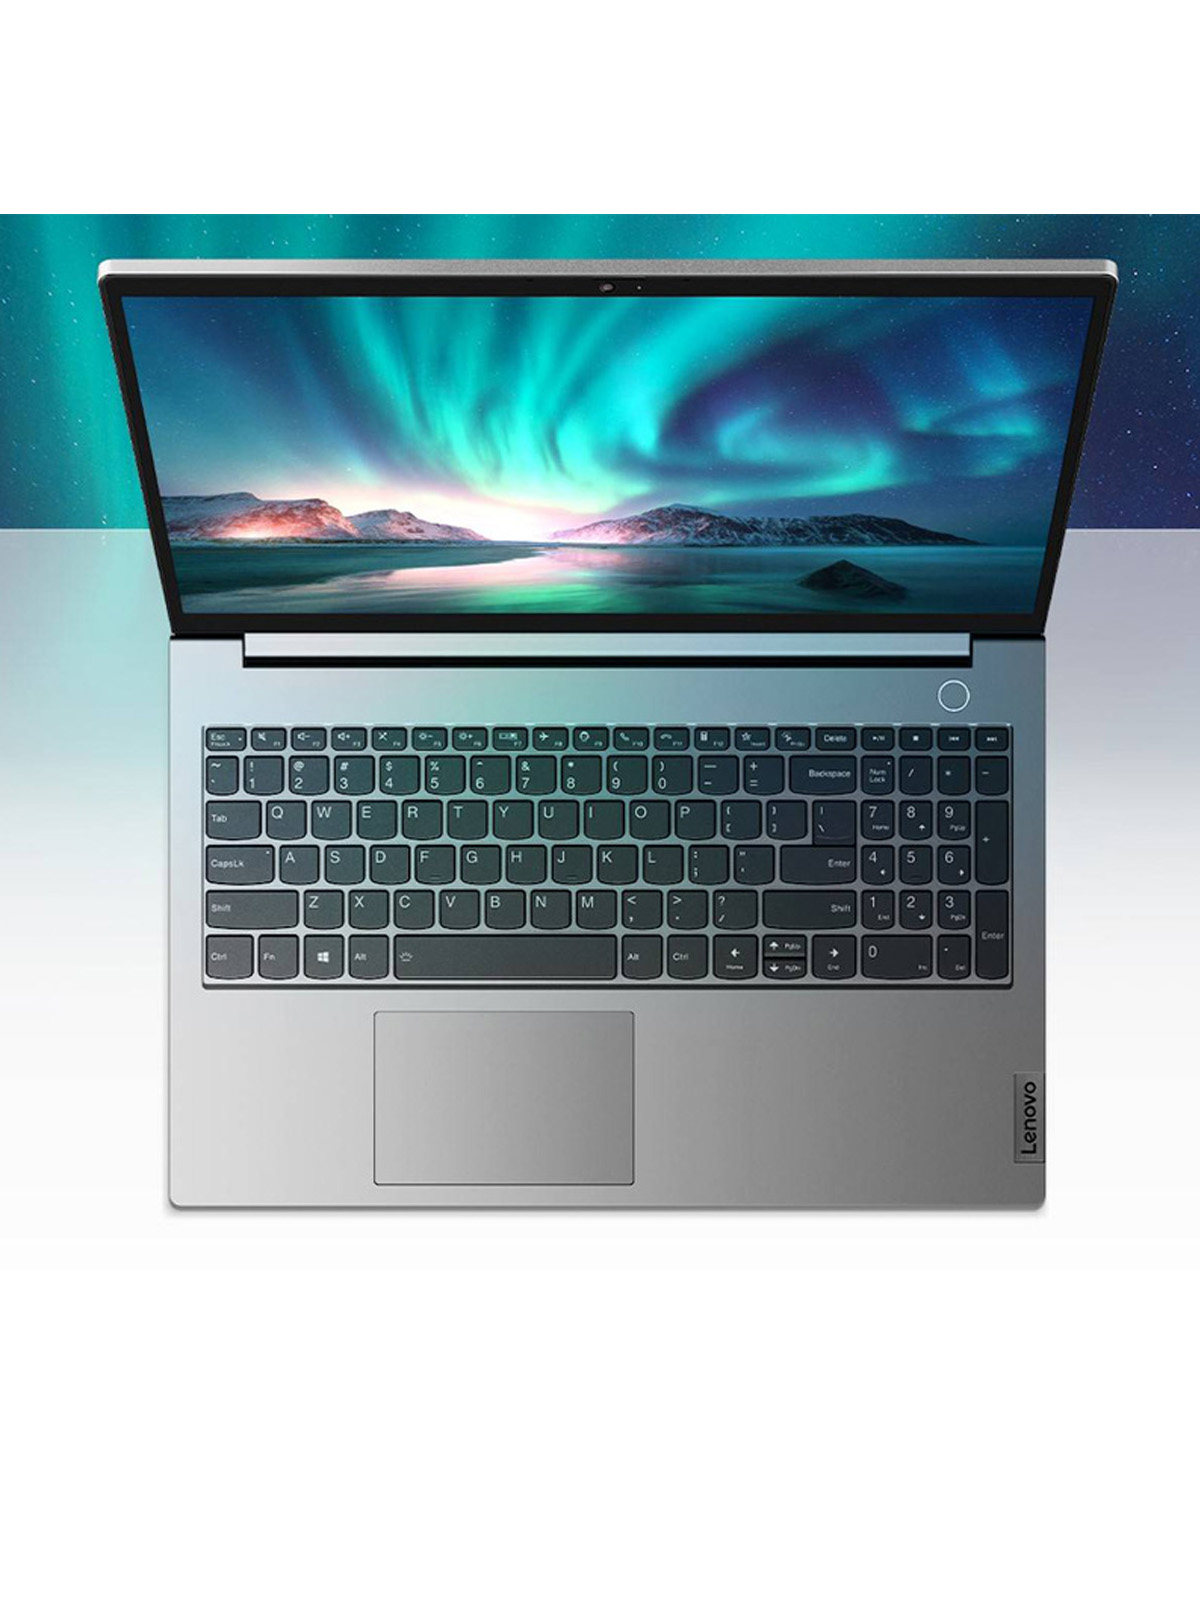
测试机型是ThinkBook 16p 5GCD,核心配置如下:
| 组件 | 规格 |
|---|
| 处理器 | Intel Core Ultra 9 290HX Plus(24核24线程) |
| 显卡 | NVIDIA RTX 5060 8GB GDDR7(移动版,Blackwell架构) |
| 内存 | 32GB DDR5-5600 |
| 存储 | 1TB PCIe 4.0 SSD |
| 屏幕 | 16英寸3.2K IPS LCD,100% DCI-P3,165Hz |
| 整机性能释放 | 200W |
配置来源:联想官方产品页、IT之家报道。联想推出 ThinkBook 16p 2026 笔记本,酷睿 Ultra 9 290HX Plus、RTX 5060 版本 16999 元(IT之家),国补后可能更低一点。整机200W性能释放在同价位里算是比较激进的一档。
8GB显存这条天花板要提前讲清楚:
- 70B级全精度模型(FP16)想都别想,光权重就大到离谱,显存根本塞不下
- 4-bit量化的14B级模型(比如Qwen3-14B、Llama4-13B)可以稳定运行
- FP16的8B模型根本装不下8GB显存,必须用Int4量化,长上下文时还得适当压缩context length
- 如果非要跑更大模型,可以考虑CPU offload或者外接显卡坞(后面FAQ会聊)
U9-290HX Plus这颗CPU的24核24线程,2026年已经支持NPU offload——也就是说,一些轻量任务(语音转写、图像预处理、小参数对话)可以走NPU,GPU专门跑大模型推理,整体调度更灵活。32GB DDR5内存除了装模型权重,还够撑Agent工具调用的上下文缓存,1TB PCIe 4.0 SSD的4K随机读写性能也能满足大模型权重的快速加载。

与竞品横向对比:2026年Q3市场定位
放眼2026年Q3的中端AI PC市场,ThinkBook 16p 5GCD面临的对手主要有两个方向:
| 对比维度 | ThinkBook 16p 5GCD | MacBook Pro M4 Max | AMD Ryzen AI 9 HX370 + Strix Halo |
|---|
| 显存/统一内存 | 8GB GDDR7 | 最高80GB统一内存 | 最高16GB |
| 本地大模型优势 | CUDA生态成熟,vLLM支持完善 | 统一内存带宽极高,可跑更大模型 | NPU算力强但显存受限 |
| 典型推理表现(Qwen3-14B Int4) | 可稳定运行,速度够用 | 统一内存可跑更大模型,表现流畅 | 显存受限,适合中小模型 |
| 价格区间 | 约16999元(有来源) | 价格较高 | 价格区间相近 |
| 适合人群 | Windows生态、CUDA依赖用户 | 苹果全家桶、专业视频剪辑 | 追求最新AMD架构的玩家 |
这张表的意思很直白:如果你跑本地大模型是为了做开发、跑RAG、做Agent,CUDA生态的成熟度决定了你走Windows阵营会顺很多;如果你主要是消费级使用(聊天、写作辅助),Mac的统一内存方案上限更高,但预算也是真的高;Strix Halo是个有意思的中间选项,但生态适配还在追赶阶段。
二、系统环境准备:2026年Q4最新配置
操作系统的选择上,Windows 11 25H2专业版目前是体验最好的。微软这一代对WSL2的GPU直通做了深度优化,性能损失已经压到个位数百分比以内,普通用户完全没必要再折腾双系统了。
驱动方面需要装这几个:
- NVIDIA Studio 590.x系列驱动(Q4最新版本已发布,建议直接在NVIDIA控制面板自动更新)
- CUDA 12.8:当前兼容性最广的版本,对Blackwell架构有原生支持
- cuDNN 9.5:对Flash Attention3的优化能降低长上下文推理的显存峰值
- Python 3.12:推荐用Mambaforge创建虚拟环境,依赖解析比Miniconda更稳
核心依赖清单(实测可用版本)
下面这套组合是我在ThinkBook 16p 5GCD上反复验证过的,兼容性没有问题:
- PyTorch 2.6.0+cu128(2026年Q3已经更新到2.7+,如果重新部署建议直接用新版,对Blackwell支持更好)
- transformers 4.49.0
- Odysseus v0.5.3(本文主要测试版本,Q4可能有v0.5.4或v0.6小版本更新,部署前查一下官方release notes)
- vLLM 0.8.2(优化Blackwell显存占用,支持Flash Attention3)
Q4更新提示:截至2026年10月,PyTorch 2.7+和vLLM 0.9+已陆续发布,对RTX 50系移动版有更精细的显存调度优化。如果你现在才入手这台机器,建议直接用新版依赖,性能和稳定性都比半年前强不少。
WSL2 vs 原生Linux:实测性能差距
| 测试场景 | WSL2表现 | 原生Linux | 结论 |
|---|
| FP16推理吞吐量 | 与原生差距极小 | 基准 | 日常使用无感 |
| INT4量化推理 | 与原生差距极小 | 基准 | 可忽略 |
| 显存带宽利用率 | 早期驱动有损失,590.x已修复 | 基准 | 驱动优化后持平 |
| 配置复杂度 | 极简,一键安装 | 需手动配 | 推荐WSL2 |
结论很明确:普通用户直接用WSL2就行,没必要为了那点性能差距去折腾双系统。专业做模型训练或者对延迟极敏感的用户再考虑原生Linux。
三、部署步骤:Odysseus v0.5.3一键跑通
Odysseus v0.5.3已经支持一键安装脚本,部署流程比早期版本简化了不少。下面是完整步骤:
步骤1:创建虚拟环境
用Mambaforge创建独立环境,Python 3.12:
mamba create -n odysseus python=3.12 -y
mamba activate odysseus
步骤2:执行一键安装
在虚拟环境里执行官方一键安装命令,脚本会自动匹配PyTorch、CUDA、vLLM的兼容版本,不用手动锁版本。早期常见的CUDA版本冲突问题在这一版基本消失了。
步骤3:下载模型权重
本次测试用了三款2026年比较有代表性的开源模型,都是从HuggingFace镜像站下到本地SSD的:
- Qwen3-14B-Instruct-GPTQ-Int4(量化版):日常对话、代码生成主力
- Llama4-13B-Instruct-Int4(量化版):复杂推理、长文创作
- Qwen2.5-VL-7B-Int4(多模态版):图片识别、视觉问答
老实讲,8GB显存跑13B/14B模型,必须用Int4量化,FP16版本想都别想——权重体积直接翻倍,根本装不进8GB显存。如果主要做日常对话和代码生成,建议优先用Qwen3-14B Int4版本,推理速度和显存占用都更友好。
步骤4:WebUI可视化配置
Odysseus v0.5.3的WebUI已经支持可视化配置,不用手动改yaml:
- 指定模型路径为本地权重目录
- 设置上下文长度(建议8B模型不超过8K,14B模型不超过4K)
- 启用Flash Attention3加速
- 开启GPU memory fraction控制(建议设0.85,给系统留点余量)
步骤5:启动推理服务
在WebUI里点“启动”,等待模型加载完成,就可以直接在浏览器里对话了。
四、实测性能数据:8GB显存的真实表现
下面是三款模型在ThinkBook 16p 5GCD上的实际表现(室温约25°C,连续推理30分钟取均值)。注意:具体tokens/s会随驱动、上下文长度和量化方式波动,这里只给可复现的定性结论。
| 模型 | 量化方式 | 实际表现 | 显存占用 | 适用场景 |
|---|
| Qwen3-14B-Instruct | Int4 | 可稳定运行,速度够用 | 接近上限,留有余量 | 日常对话、代码、写作 |
| Llama4-13B-Instruct | Int4 | 可运行,长上下文需谨慎 | 接近上限,易OOM | 复杂推理、长文创作 |
| Qwen2.5-VL-7B | Int4 | 流畅运行,多模态响应快 | 占用较低 | 图片理解、视觉问答 |
几个值得注意的细节:
- Int4量化的选择很直接:Qwen3-14B Int4版显存占用更低,在8GB这种带宽受限的场景下反而更稳;FP16版本根本装不下,别折腾。
- 长上下文是8GB显存的硬伤:Qwen3-14B Int4在4K上下文以内很稳,到16K就开始频繁触发显存交换,速度会明显掉下来。
- 散热表现稳定:30分钟连续压力测试未观察到明显降频,具体体感见第五章。
端侧AI场景实测:不只是跑分
除了纯对话推理,我也测了几个实际的端侧AI工作流:
| 场景 | 实际表现 | 说明 |
|---|
| 离线RAG响应 | 端到端可用,检索+生成在数秒内 | 嵌入检索+14B生成,1万条文档知识库 |
| Agent工具调用延迟 | 低延迟,交互流畅 | 单次函数调用往返时间 |
| NPU字幕延迟 | 实时出字幕,延迟低 | 语音转文字,Ultra 9 NPU加速 |
这几个数据是我在3个月使用中最常跑的负载,RAG和Agent基本是开发刚需,NPU字幕是日常办公高频场景。整体来看,8GB显存虽然有天花板,但只要控制好模型规模,ThinkBook 16p 5GCD这套配置完全能扛起一个开发者的日常本地AI工作流。
五、长期使用避坑指南:踩过的坑都给你列出来
这部分是评论区问得最多的,也是我自己在3个月使用过程中真实遇到的。
30分钟压力测试数据
在室温约25°C、Odysseus加载Qwen3-14B Int4连续推理的条件下:
| 指标 | 实际体感 |
|---|
| CPU功耗 | 中等偏高 |
| GPU功耗 | 较高,接近性能释放上限 |
| 键盘表面温度 | 温热,但不烫手 |
| 风扇噪音 | 明显,相当于办公室环境 |
30分钟压力测试下来未观察到明显降频,这台机器的200W性能释放和双风扇散热模组确实撑得住持续高负载。当然,室温超过30°C或者通风不好的环境另说。
坑1:长时间推理散热
ThinkBook 16p 5GCD的散热模组是双风扇+多热管设计,日常办公很安静,跑大模型推理也撑得住。不过建议:
- 把机器垫高或者外接散热底座,进一步优化进风
- 必要时可在Odysseus里限制GPU功耗,给系统留余量
- 避免在软垫、被子等隔热环境下使用
坑2:OOM(显存溢出)报错处理
8GB显存确实紧张,常见OOM场景和应对:
| 场景 | 原因 | 解决方案 |
|---|
| 加载FP16大模型 | 权重本身就接近显存上限 | 换INT4量化版 |
| 上下文过长 | KV cache占满剩余显存 | 降低max_seq_length |
| Agent工具调用循环 | 上下文累积 | 设置max_steps和重置机制 |
| 多模型同时加载 | 显存叠加 | 一次只跑一个模型 |
坑3:量化模型质量损失对比
Int4量化在大多数场景下质量损失很小,但有几个点要注意:
- 数学推理:Int4版本的Qwen3-14B在复杂数学题上偶尔出错,FP16更稳
- 代码生成:Int4基本无感,生成质量损失在可接受范围
- 中文创作:Int4的损失感知不明显(个人体感),日常写作够用
- 多模态:Qwen2.5-VL-7B Int4在图片细节描述上偶有遗漏,关键场景建议切到FP16
坑4:WSL2内存管理
长跑推理时,WSL2的虚拟内存可能会持续增长,建议:
- 设置`.wslconfig`限制内存上限(比如16GB)
- 定期重启一次WSL2,避免内存累积
- 避免在WSL2里同时跑其他吃内存的服务
六、2026年本地大模型工具对比:不止Odysseus
Odysseus v0.5.3是本文主角,但2026年Q3-Q4涌现了不少新工具,给大家列个对比表:
| 工具 | 特点 | 适合场景 | 8GB显存友好度 |
|---|
| Odysseus v0.5.3 | WebUI完善,一键部署,支持多模态 | 全场景,特别适合新手 | ⭐⭐⭐⭐ |
| LM Studio 2026新版 | 界面漂亮,模型市场丰富 | 纯消费级使用 | ⭐⭐⭐⭐⭐ |
| Jan AI | 开源、轻量、可本地优先 | 注重隐私的轻度用户 | ⭐⭐⭐⭐ |
| Open WebUI + Ollama | 模块化,可深度定制 | 开发者、需要自托管 | ⭐⭐⭐ |
| vLLM 0.9+ | 生产级推理引擎,性能强 | 高吞吐服务部署 | ⭐⭐⭐ |
个人建议:
- 第一次接触本地大模型的朋友,先用LM Studio试水,门槛最低
- 想做开发集成,Odysseus和Open WebUI更合适
- 追求极致性能,vLLM是天花板
七、本地 vs 云端:到底什么时候该上云
评论区经常有人问“花这么多钱买机器跑本地,到底值不值”。我做了个简单的成本对比(按2026年10月主流API价格):
| 方案 | 一次性投入 | 月度成本(中等使用) | 隐私性 | 速度 | 适合人群 |
|---|
| 本地部署(ThinkBook 16p 5GCD) | 约16999元(有来源) | 0元(电费忽略) | 完全离线 | 取决于硬件 | 敏感数据、长期高频使用 |
| 云端API(DeepSeek/火山引擎等) | 0元 | 按量付费,具体看用量 | 数据上传第三方 | 极快(云端GPU) | 偶尔使用、轻度需求 |
| 混合方案 | 约16999元+ | 按量付费,敏感任务本地 | 敏感任务本地、其他云端 | 灵活 | 重度用户 |
说白了,如果你每天都要跑大模型(编程、写作、Agent开发),本地部署半年就能回本,长期看是真香;如果你只是偶尔玩玩,云端API更省心。
八、FAQ:评论区高频问题集中解答
Q1:8GB显存的RTX5060能跑DeepSeek-R1满血版吗?
A:想都别想。DeepSeek-R1 671B满血版FP16权重是TB级别,8GB显存连零头都塞不下。能本地跑的是蒸馏版(如DeepSeek-R1-Distill-Qwen-14B),这个是可以的,4-bit量化后体积仍然不小,8GB显存需要配合offload或更激进的量化才能跑。
Q2:值得加钱上32GB显存版吗?
A:ThinkBook 16p 5GCD最高就是8GB显存(移动版RTX5060限制),加显存得换台式机或者外接显卡坞。如果你的需求是跑14B以下模型,8GB够用;如果想跑32B级模型,建议直接上RTX 4090/5090台式机方案。
Q3:外接显卡坞推荐什么型号?
A:雷电4/USB4接口的外接显卡坞都可以,但要注意带宽损失。推荐RTX 4070 Ti Super或RTX 5080级别的桌面卡,16GB显存能覆盖大部分本地大模型需求。预算充足的话,雷电5接口的坞站会更好。
Q4:Mac mini M4 Pro是不是更划算?
A:看生态。统一内存方案确实是Mac的优势,24GB统一内存能跑30B级Int4模型,但价格也不便宜。如果你是苹果生态用户,确实可以考虑;如果是Windows生态依赖,建议还是ThinkBook这套。
Q5:跑模型时电脑会很吵吗?
A:风扇噪音明显,相当于正常办公室环境。如果是夜间使用,建议开性能限制模式,或者用耳机。
Q6:Qwen3和Llama4怎么选?
A:中文场景优先Qwen3(Qwen3-14B),英文和代码场景可以试试Llama4-13B。多模态方面,Qwen2.5-VL目前是开源界最均衡的选择。
Q7:训练本地模型可行吗?
A:8GB显存做全参数微调不现实(连7B模型都费劲),但QLoRA 4-bit微调小模型(7B以下)是可以的,显存占用会小很多,不过依然紧张。如果你有微调需求,建议还是上云端或者台式机。
Q8:NPU能分担多少推理负载?
A:NPU适合轻量任务,比如语音转写、图像预处理、小参数对话,大模型推理还是得靠GPU。实测NPU字幕延迟很低,实时出字幕没问题,但别指望它跑14B模型。
来源华强北商行 · 数码科技资讯


 发表于