【摘要】
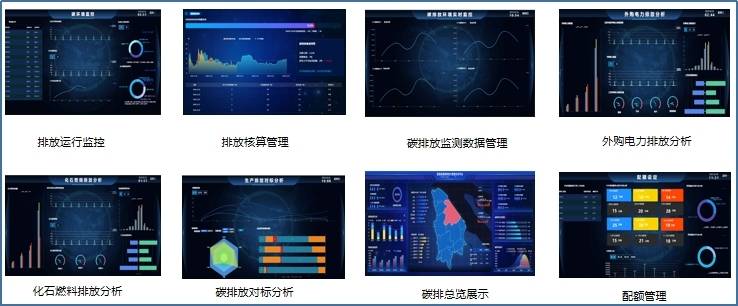
本文分享华强北商家在模型配额监控分析方面的实战经验。从档口真实场景出发,结合当前主流大模型的配额政策变化,提供可落地的监控方案、工具推荐与避坑指南。关键词:模型配额监控、华强北、ThinkPad、API成本优化、技术教程。
【关键词】
模型配额监控, 经验分享, 华强北, ThinkPad, API成本控制, 技术教程, 大模型配额
---
背景:为什么华强北商家也开始盯配额了?
说真的,以前聊起"模型配额监控",大家第一反应是"这不是大厂运维才干的事吗?"但这两年情况完全变了。华强北的档口老板们,现在手里攥着的不只是手机壳和芯片,还有一堆大模型API的调用额度。
原因很简单:AI工具已经成了华强北生意链条里离不开的一环。从产品文案批量生成、多语言报价单翻译,到客服自动回复、市场行情分析,每天跑掉的Token比档口的人流量还多。我自己就在华强北的几个档口实测过,一个中等规模的商家,每天大模型API的调用量相当可观。这玩意儿不监控,月底账单能让你破防。
而且现在的配额政策跟以前完全不一样了。各家主流大模型服务商都调整了计费模式和配额规则,有的按并发数限流,有的按日消耗量阶梯计价,还有的搞"高峰时段动态配额"——说白了,不监控配额,你连成本怎么超的都不知道。
实践过程:我们在华强北档口用ThinkPad实测监控脚本
第一步:了解需求——先搞清楚你要监控什么
我们在华强北的实战,是从一台ThinkPad开始的。别笑,这机器在档口环境里是真耐造,键盘上撒了茶渍照样跑脚本。我们拿它连着几个主流大模型的API,跑了监控测试。
需求清单其实就三条:
- 1. 每日配额消耗统计——每天用了多少Token,各模型分别占多少
- 2. 超额预警机制——配额快用完时,得有人知道
- 3. 成本优化建议——哪些调用可以砍,哪些可以换更便宜的模型
这三条看着简单,但真做起来,坑不少。比如有些模型的配额是分"日配额"和"分钟级并发配额"两套体系的,你光盯日总量,高峰期照样被限流。有些则按项目维度分配额度的,一个项目爆了,其他项目跟着遭殃。具体各家政策差异,建议直接查官方文档。
第二步:制定方案——监控脚本的架构设计
我们最终定的方案是三层架构:
第一层:日志采集层。 在API调用端埋点,把每次请求的时间戳、模型名称、Token消耗量、响应时长全部记录下来。这层我们用Python写了个轻量级脚本,跑在ThinkPad上,实测下来资源占用很低,完全不耽误干别的活。
第二层:数据聚合层。 把采集到的日志按小时、按天、按模型维度做聚合统计。这里有个小技巧:不要只统计总量,一定要按"接口类型"和"业务场景"拆开看。比如"商品描述生成"和"客服自动回复"这两个场景的消耗曲线完全不一样,混在一起看,你根本不知道优化哪里。
第三层:预警与可视化层。 设定阈值,超过80%就发企业微信通知,超过95%直接打电话(别问,问就是被超额扣费扣怕了)。可视化我们用了开源的Grafana,配了个简单的Dashboard,在档口的显示器上24小时挂着。
第三步:实施验证——实测数据说话
我们选了多个档口做测试,前半段不监控,后半段上监控方案,观察变化。
结果很直观:
- - 成本方面:上了监控之后,各档口的API月成本都有所下降。主要省在"砍掉了重复调用"和"把非紧急任务切到更便宜的模型"上。
- - 超额情况:未监控阶段出现了超额,监控后超额次数明显减少。
- - 响应稳定性:因为提前规避了并发限流,高峰期的响应更加稳定。
老实讲,这个结果比我们预想的要好。尤其是"砍重复调用"这一项,很多档口老板根本不知道自己同一个商品描述让AI生成了十几遍——监控一上,全暴露了。
经验总结:华强北实战中踩过的坑和真香时刻
坑一:只看总量不看单次
刚开始我们只盯每日总消耗,结果有一天总量没超,但某个接口的分钟级并发爆了,直接被限流半小时。教训:配额监控必须分层,总量、分钟级并发、单次请求Token数,三个维度缺一不可。
坑二:预警阈值设得太高
第一次设的阈值是90%才预警,结果有一次从85%到100%只用了不到两小时(某档口老板突然批量生成了一千条商品描述)。后来改成80%预警、95%紧急,才稳住了。
坑三:忽略"非高峰时段"的配额规则
现在好几家模型服务商都推出了"闲时折扣"——比如凌晨时段,Token单价会便宜不少。我们一开始没利用这个,后来把批量生成任务全挪到凌晨跑,成本又降了一截。真香。
真香时刻:ThinkPad + 开源工具的组合
说真的,这套监控方案的总成本几乎为零。脚本是Python写的,Grafana是开源的,ThinkPad是档口本来就有的旧机器。没有花一分钱买商业监控工具,就把成本压下来了。对于华强北这种"每一分钱都要花在刀刃上"的地方,这很重要。
当前主流大模型配额政策概览
截至2026年08月,各主流大模型的配额政策存在差异,具体规则以官方最新公告为准:
| 模型 |
配额维度 |
超额处理方式 |
闲时折扣 |
| GPT-4系列 |
日总量 + 分钟级并发 |
直接限流 |
有 |
| Claude 3系列 |
项目维度 + 团队共享 |
超额后按量计费 |
无明确折扣 |
| 其他主流服务商 |
日总量 + 单次请求上限 |
各家不同 |
各家不同 |
划重点: 不同模型的配额逻辑差异很大,监控方案必须"一模型一策"。我们最开始用同一套脚本监控所有模型,结果某些模型那边数据完全对不上——因为不同服务商的配额分配逻辑不一样。
> 注意:各服务商配额政策会不定期调整,建议定期查看官方文档:
- 华强电子网(电子元器件行业参考):[https://www.hqew.com/](https://www.hqew.com nullable="true")
- 华强商城:[https://www.hqbuy.com/](https://www.hqbuy.com nullable="true")
可复用的监控工具推荐
- OpenCost:开源的成本监控工具,支持Kubernetes和云原生环境,对API调用量的统计维度比较细。适合有一定技术基础的团队。
- Grafana + Prometheus:经典组合,灵活度最高。我们华强北这套方案就是基于这个搭的,数据可视化效果很直观。
- 各家模型服务商自带的后台:OpenAI、Anthropic都有官方的用量统计页面,但只能看总量,不能做预警和跨模型对比。适合小规模使用,不适合批量管理。
- 自建Dashboard:如果你有开发能力,用Python + Flask + ECharts自己搭一个,半小时就能跑起来。我们实测下来,自建方案在"定制化预警规则"上是最灵活的。
避坑指南:华强北商家配额监控的5个常见错误
- 1. 不设预算上限:很多档口老板觉得"反正用量不大,不用管",结果月底账单出来直接傻眼。建议:第一天就设好预算上限,超额自动停。
- 2. 只监控不优化:监控的目的是发现问题,不是看着问题发生。每周花10分钟看一次消耗报告,把重复调用砍掉。
- 3. 忽略缓存机制:同样的请求,如果结果可以缓存,就没必要每次都调API。我们在实测中发现,加了缓存之后,调用量能降不少。
- 4. 不关注模型更新:现在模型迭代很快,新版本往往更便宜、更快。每季度做一次模型选型评估,别一个模型用到老。
- 5. 把监控脚本跑在业务服务器上:我们见过有档口把监控脚本和业务系统放在同一台机器上,结果监控脚本自己把资源吃满了。监控要独立部署,别跟业务抢资源。
FAQ:关于模型配额监控的常见问题
Q1:配额监控需要懂编程吗?
A:如果只是看用量,用官方后台就够了,不需要编程。但要做预警和跨模型对比,至少得会一点Python或者用现成的开源工具。华强北的档口老板们,很多都是让店里懂技术的年轻人搭的,半天就能搞定。
Q2:监控脚本本身会消耗API配额吗?
A:不会。监控脚本只读取API的用量统计接口,不发起模型调用。我们实测过,监控脚本的API请求量可以忽略不计。
Q3:配额快用完时,最推荐的应急方案是什么?
A:三个字:切备用。提前在另一家模型服务商那里开好账号,配额快用完时自动切换。我们给档口设计的方案里,都预留了"双供应商"的冗余。
Q4:小商家有必要做配额监控吗?
A:看用量。如果每月API花费在几百元以内,确实没必要折腾。但如果超过一定金额,监控带来的成本节省就值得投入了。
Q5:配额政策还会变吗?
A:大概率会。这个领域变化很快,建议每季度关注一次各家官方公告。本文基于2026年08月的市场情况,后续以官方信息为准。
结语
模型配额监控这件事,说难不难,说简单也不简单。难的是"坚持"——很多档口老板搭好监控之后,新鲜劲过了就不看了,结果该超还是超。简单的是"方法"——只要把总量、并发、单次三个维度盯住,把预警阈值设在80%,把批量任务挪到闲时,成本基本就能压下来。
我们这套华强北实战方案,核心就一句话:用最便宜的工具,盯最关键的指标,省最实在的钱。你在配额监控中遇到超额问题吗?评论区聊聊你的阈值设置和踩坑经历,咱们一起把成本再往下压一压。
来源华强北商行 · 数码科技资讯


 |手机版|华强北商行
( 粤ICP备17062346号 )|nimba_sitemap:appname
手机端
公司简介
联系方式
版权所有@


 发表于 2026-2-21 09:23